اعداد: أوس ملحم
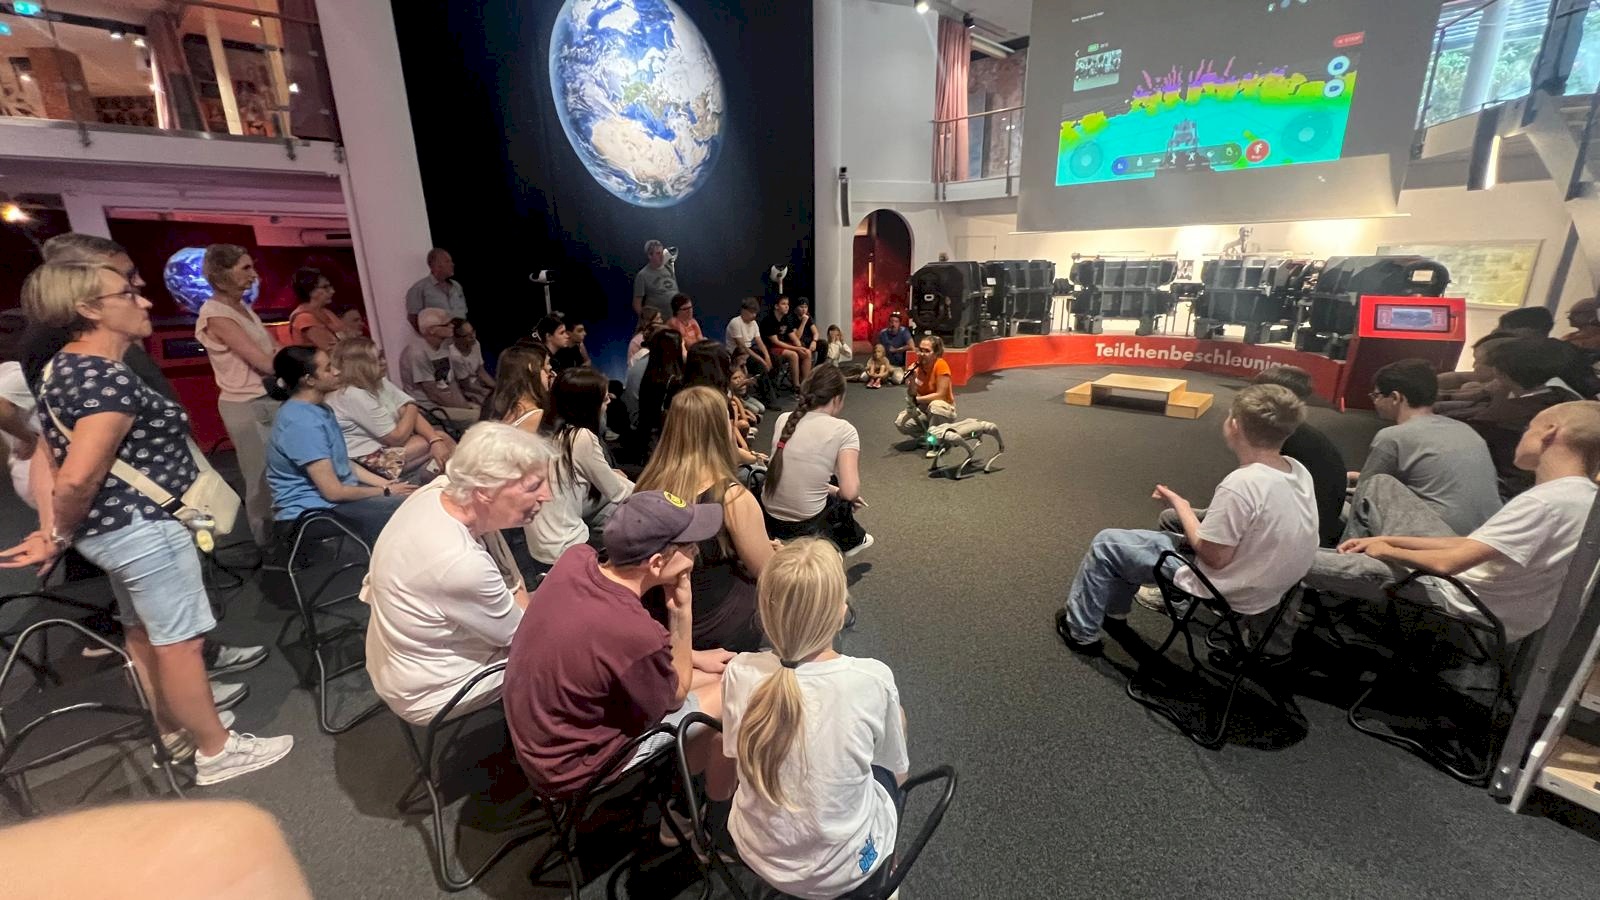
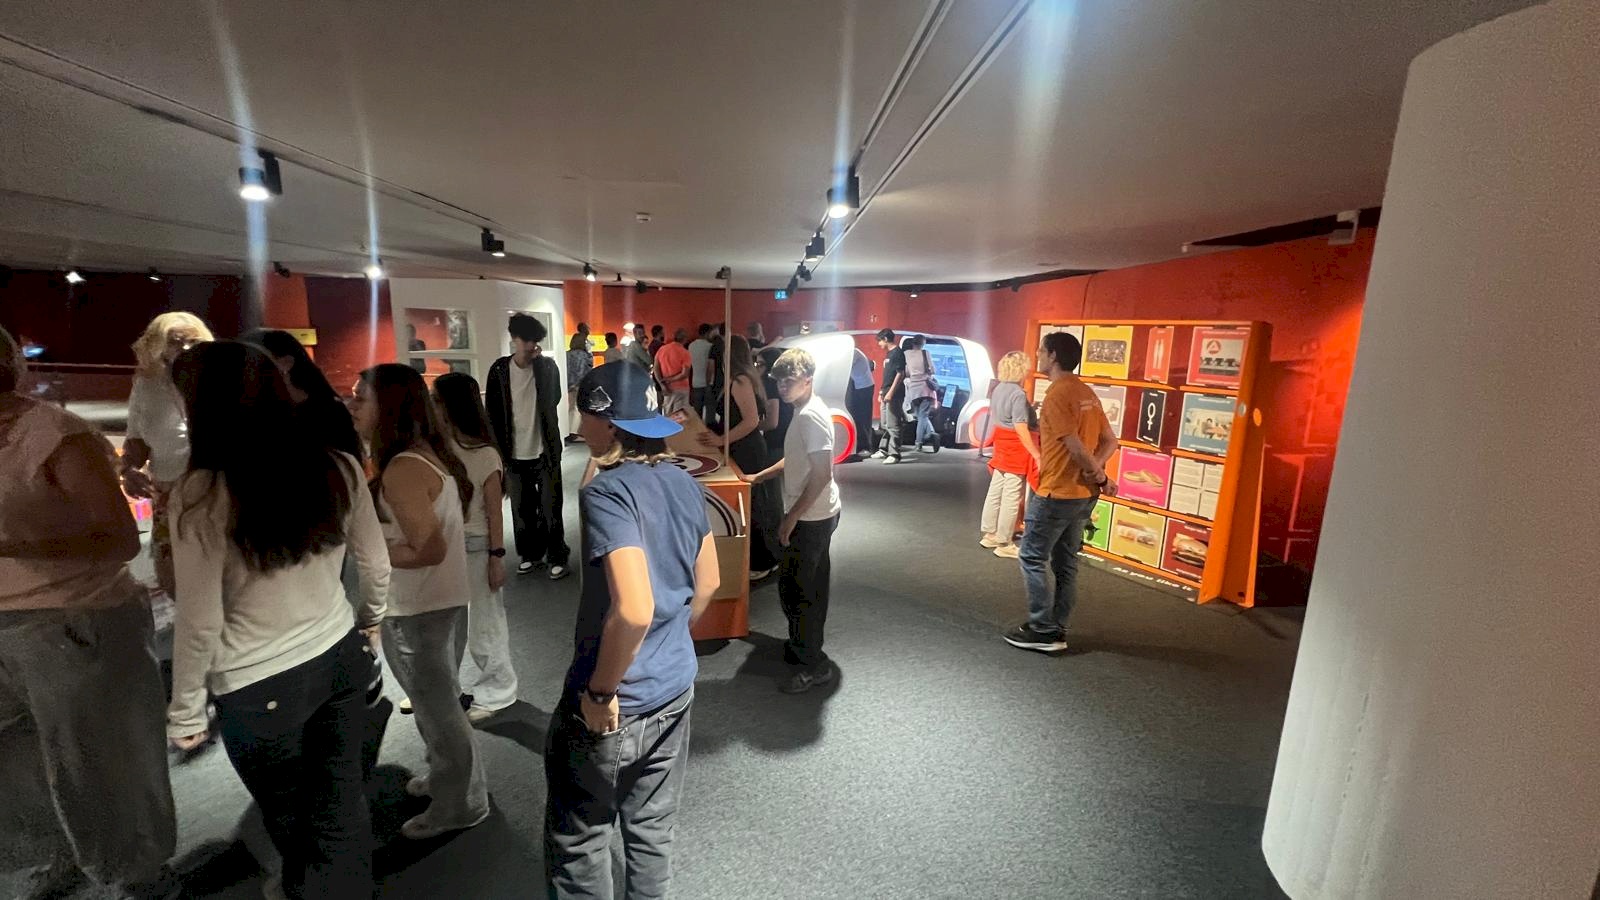
في مدينة بون، غرب ألمانيا، وتحديدًا في منطقة باد غودسبرغ، يقع المتحف الألماني في بون، الذي يقدّم اليوم مساحة مخصصة لفهم الذكاء الاصطناعي وتجربته تحت عنوان “منتدى الذكاء الاصطناعي”. في المتحف لا تسير بين قاعات مليئة بالمعلومات والقطع المعروضة خلف الزجاج، بل تنتقل من تجربة تفاعلية إلى أخرى؛ تلمس، وتجرب، وتختار، وتراقب النتيجة أمامك.
المتحف مخصص لفئات مختلفة من الزوار، من الأطفال والشباب إلى العائلات والمهتمين بالتكنولوجيا، وفكرته الأساسية أن تجرب الذكاء الاصطناعي وتفهمه بدل أن تكتفي بالحديث عنه.
واللافت أن الجولة لا تبدأ من سؤال: ما أحدث أداة للذكاء الاصطناعي؟
بل من سؤال أبسط:
كم مرة استخدمنا الذكاء الاصطناعي اليوم دون أن ننتبه؟
ربما اقترح عليك هاتفك صورة من ذكرياتك، أو صحح كلمة كتبتها، أو ترجمت لك جملة، أو اقترحت لك منصة موسيقى أغنية تناسب ذوقك، أو اختارت لك الخرائط الطريق الأسرع دون أن تنتبه، أو شاهدت إعلانًا بدا وكأنه يعرف ما تبحث عنه.
نحن نستخدم الذكاء الاصطناعي بالفعل في تفاصيل كثيرة من حياتنا، لكننا غالبًا نرى النتيجة فقط ولا نرى ما يحدث خلفها.
وهنا تبدأ جولتي.
فجأة… تظهر صورتك في زمن آخر
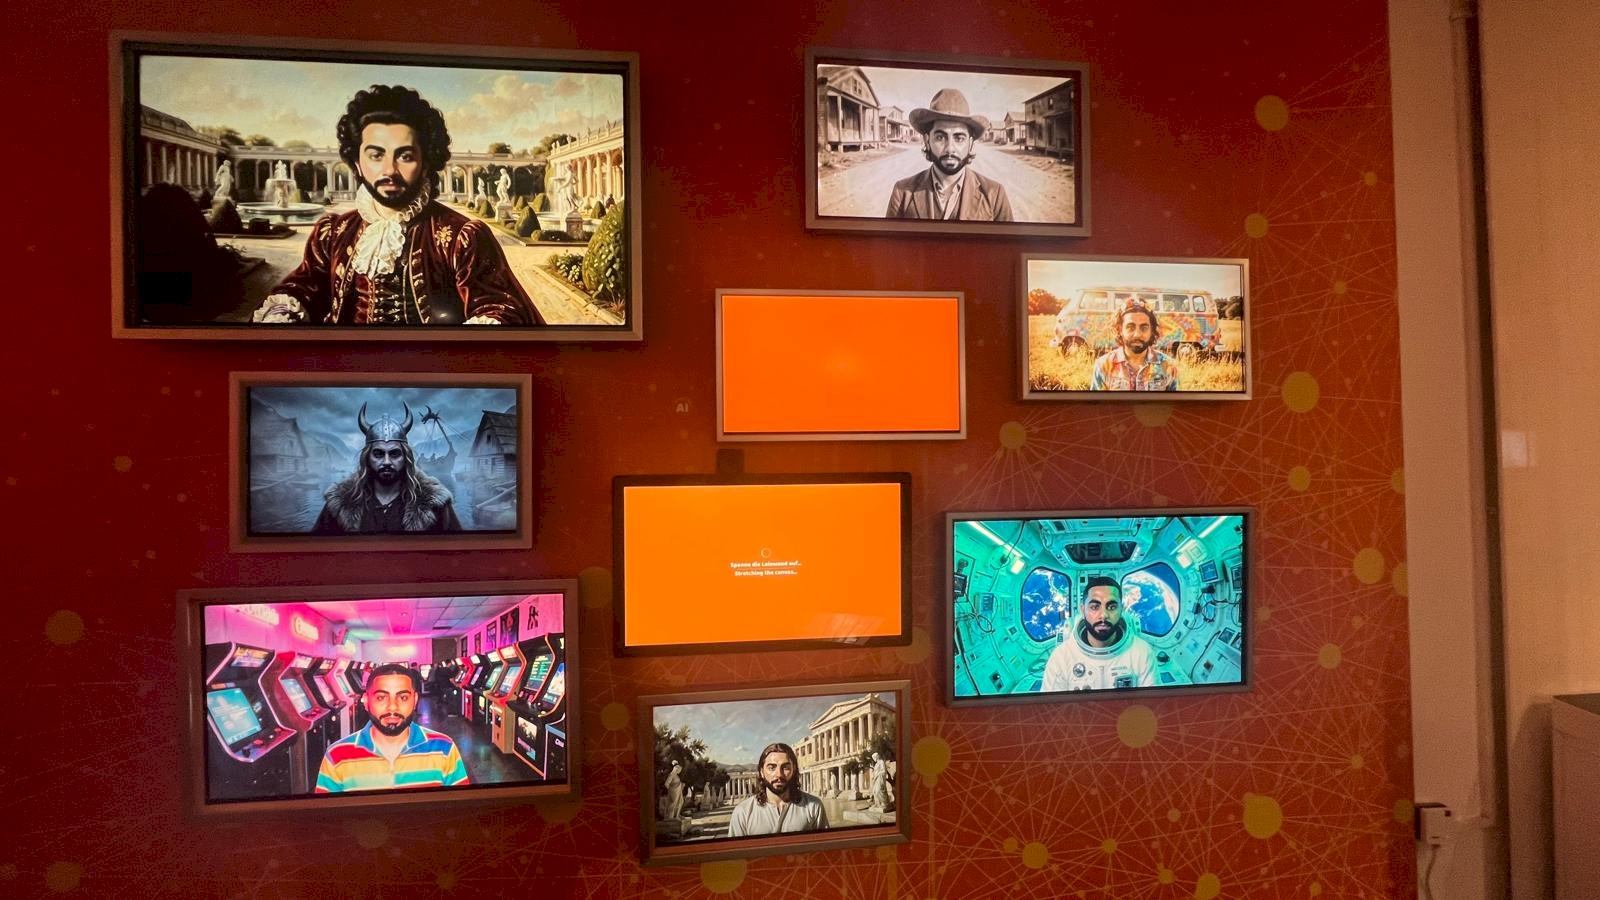
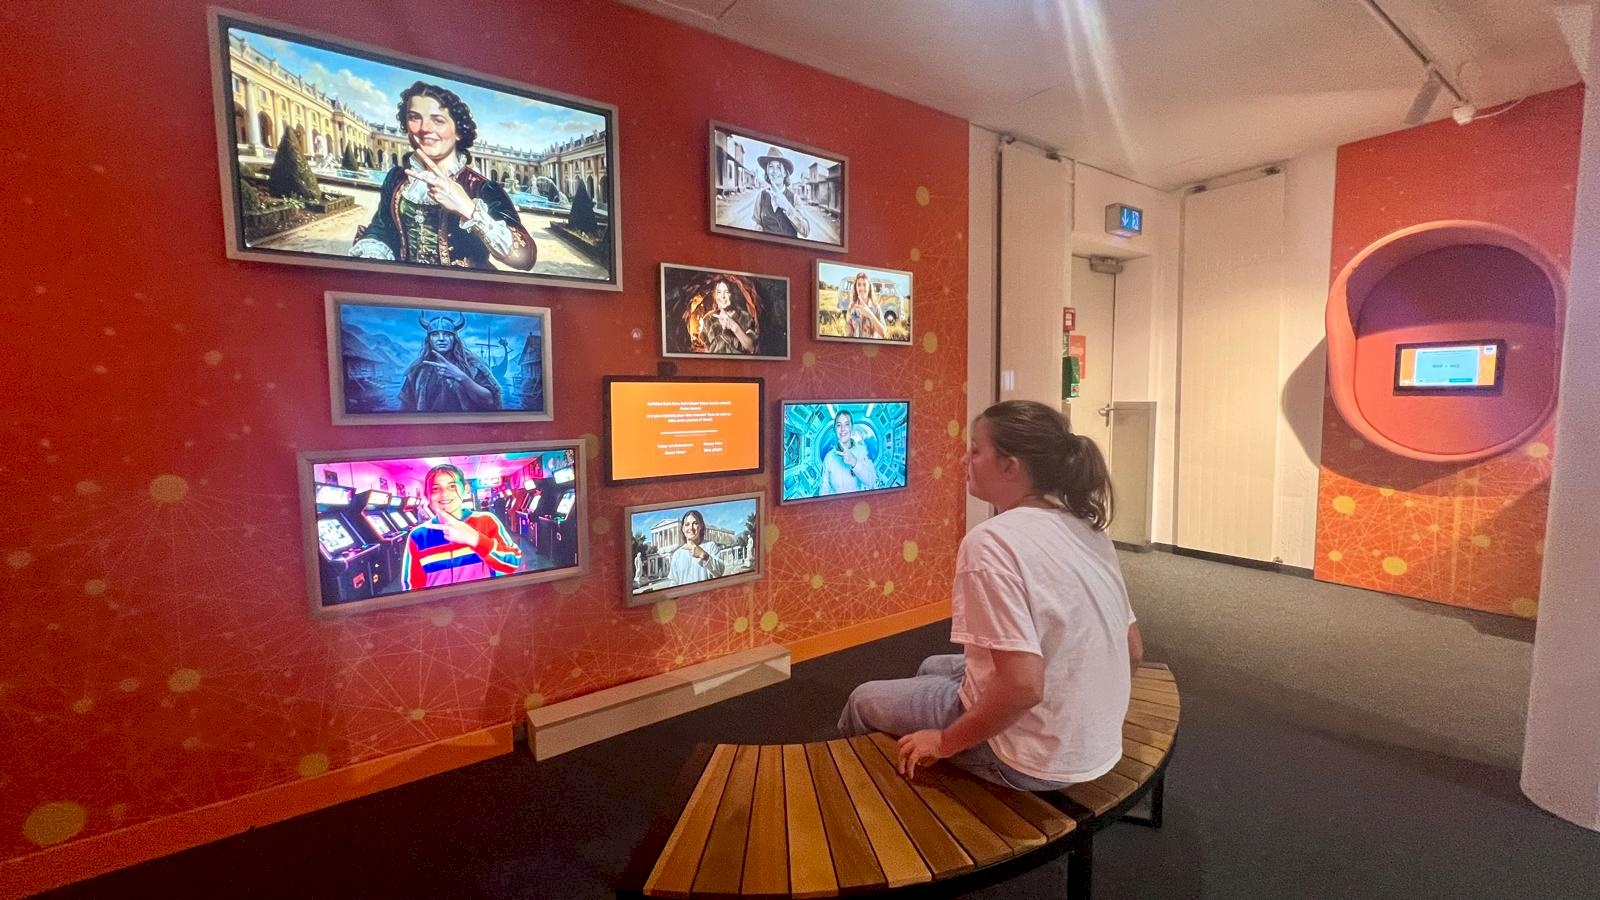
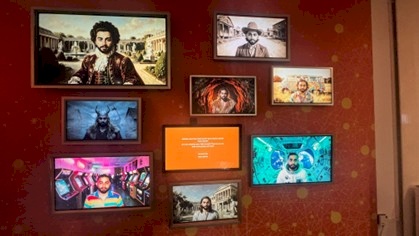
أقف أمام إحدى الشاشات وألتقط صورة لنفسي.
أنتظر لحظات، وفجأة تظهر صورتي في أزمنة وسياقات مختلفة؛ مرة في أجواء تاريخية، ومرة في عالم مستقبلي، ومرة بأسلوب فني بديع... وكأن الصورة نفسها أخذتني إلى حياة أخرى.
كانت هذه التجربة تشبه إلى حد كبير ما نراه اليوم على وسائل التواصل الاجتماعي، لكنها سبقت هذا الانتشار بفترة؛ إذ تتيح للزائر تحويل صورته إلى مشاهد تبدو وكأنه التُقطت له في السبعينيات أو الثمانينيات، أو في أزمنة تاريخية لم يعشها أصلًا. وهي الفكرة نفسها التي نراها اليوم في الترند المنتشر" تريند الثمانينات"، حيث يرفع الناس صورهم إلى أدوات الذكاء الاصطناعي ليظهروا وكأنهم جزء من زمن آخر، بصور تبدو أحيانًا كأنها خرجت من ألبوم عائلي قديم، رغم أنها صُنعت خلال ثوانٍ.
اليوم أصبح بإمكانك أن تعطي أداة للذكاء الاصطناعي صورة لك وتطلب منها " إنشاء" أو Create صورة جديدة؛ أي أن تصنع لك صورة لم تكن موجودة من قبل، اعتمادًا على صورتك والوصف الذي تقدمه لها (يسمى الــPrompt).
لكن التجربة في المتحف لا تتوقف عند دهشة الصورة.
هي تضعني أمام سؤال: كيف حدث ذلك أصلًا؟
بشكل مبسط، يحلل النظام الصورة والعناصر الموجودة فيها، ويتعرف إلى أنماط تعلمها من كميات هائلة من الصور والبيانات، ثم يستخدم ما تعلمه لإنتاج صورة جديدة تحافظ على بعض ملامحك وتضعها في السياق الذي طلبته.
وهنا تصبح التجربة أكثر أهمية من مجرد الحصول على صورة جميلة.
لأن سؤالًا آخر يتبادر إلى ذهنك كزائر مباشرة:
إذا كنا نعطي هذه الأدوات صورنا الشخصية باستمرار، فأين تذهب هذه الصور؟ وكيف يتم التعامل معها؟
ففي الوقت الذي أصبح فيه تحويل صورتك إلى نسخة من السبعينيات أو الثمانينيات مجرد ترند ممتع، من المهم ألا ننسى أن الصورة التي نرفعها ليست مجرد صورة عابرة؛ إنها بيانات شخصية نضعها في يد نظام رقمي، وقد لا نعرف بالضبط أين تُخزَّن، وكيف تُستخدم، وإلى متى تبقى، وما الذي قد يحدث لها مستقبلًا أو كيف يمكن أن تُستخدم بطرق لم نتوقعها.
هل يستطيع الذكاء الاصطناعي أن يعرف ما أشعر به؟
أنتقل إلى محطة أخرى، فأجد أمامي روبوتًا صغيرًا يحدّق بي بذكاء، ويحرك عينيه ورأسه، يتابعني يمينًا ويسارًا وفوقًا وتحتًا، وكأنه يحاول أن يفهم من يقف أمامه ويتفاعل معه.
بعد لحظات، تظهر على الشاشة احتمالات لحالتي الشعورية: سعيد، حزين، خائف، غاضب، متفاجئ أو محايد.
قد تبدو التجربة في البداية مسلية، لكن فكرتها أبعد من مجرد معرفة حالتي الشعورية الآنية.
التجربة توضح بطريقة بسيطة كيف يمكن للذكاء الاصطناعي أن يحلل ملامح الوجه، ويبحث عن علامات معينة، ثم يقارنها بما تعلّمه من أمثلة سابقة ليحاول تحديد الشعور الأقرب.
وهنا اكتشفت فرقًا مهمًا:
الذكاء الاصطناعي لا يعرف فعلًا ما أشعر به، بل يحاول التوقع من خلال ما يراه على وجهي.
فالابتسامة مثلًا قد تعني السعادة، لكنها قد تكون مجاملة ومصطنعة (كما فعلت أنا بالمناسبة)، أو إحراجًا، أو مجرد استجابة عفوية للكاميرا.
وهنا تكمن قيمة التجربة في أن تجعلنا نفهم ببساطة أن الذكاء الاصطناعي قد يحلل ما يظهر على وجوهنا، لكنه لا يعني بالضرورة أنه يعرف ما يحدث بداخلنا.
هذه المرة… أنا من يعلّم الذكاء الاصطناعي!
في محطة أخرى، تتغير الأدوار.
هذه المرة لا يقوم الذكاء الاصطناعي بتحليلي؛ أنا من أساعده على التعلّم.
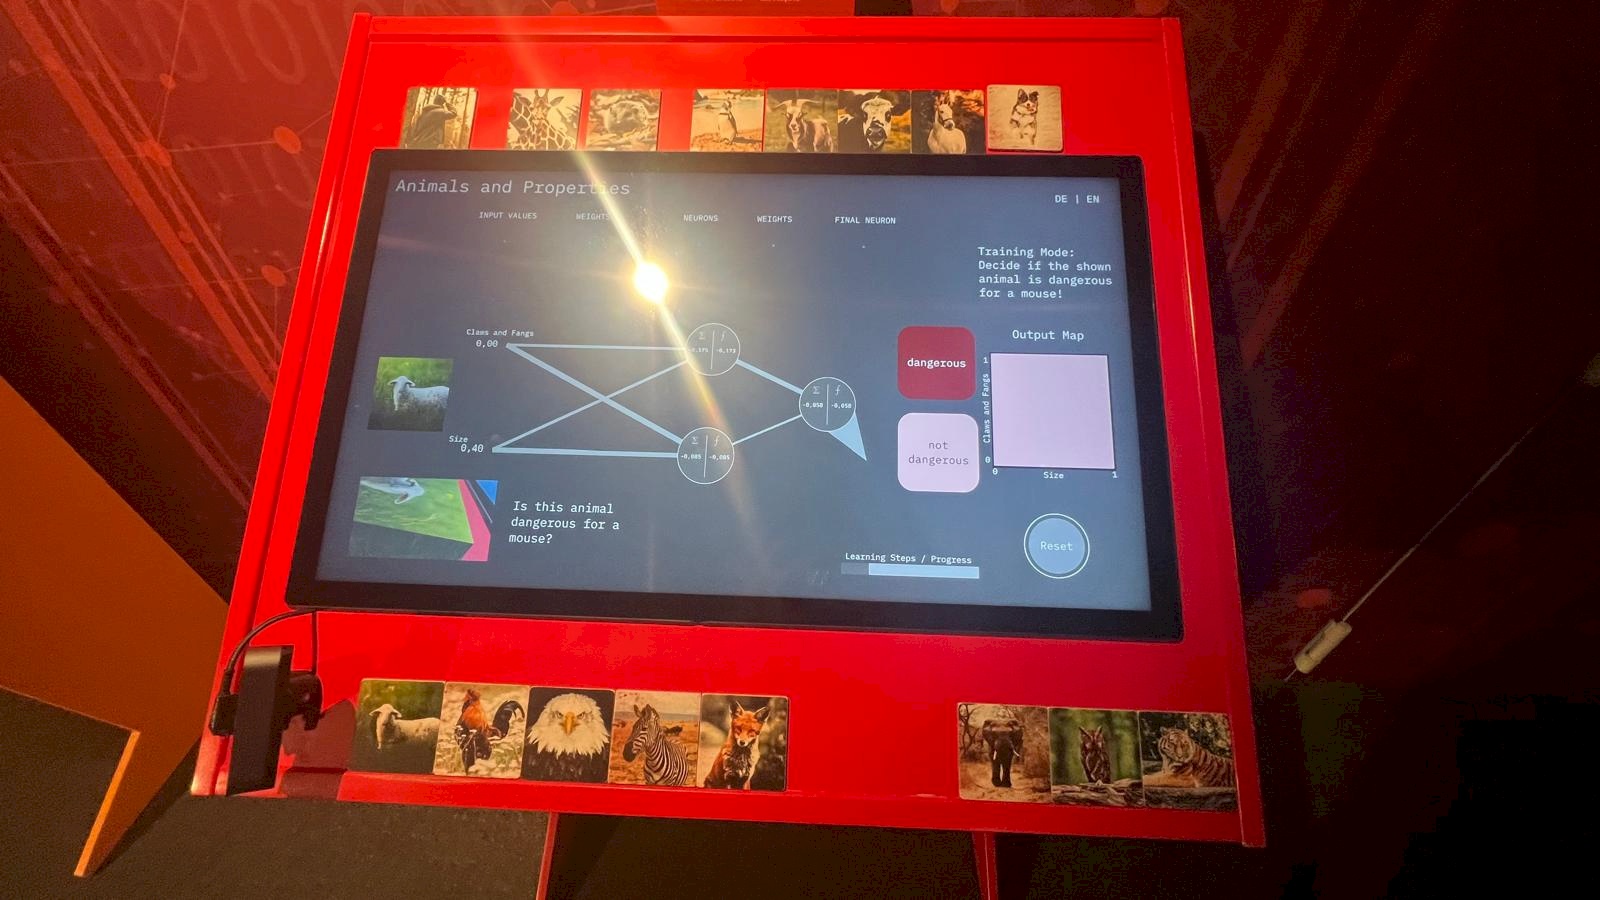
أمام الشاشة مجموعة من الحيوانات، والمطلوب أن أساعد النظام على تحديد أي منها قد يكون خطرًا على فأر.
أبدأ بإعطائه أمثلة: حيوان لديه مخالب وأنياب؟ حيوان كبير الحجم؟ حيوان لا يمتلك هذه الصفات؟
مع كل مثال، يبدأ النظام في التعلم.
ثم تظهر أمامي صورة جديدة لم يرها من قبل.
هل سيتمكن من معرفة الإجابة؟
هنا تصبح فكرة تعلم الذكاء الاصطناعي بسيطة جدًا: أعطيه أمثلة، وهو يتعلم منها، ثم يحاول استخدام ما تعلّمه عندما يواجه شيئًا جديدًا.
وهنا أفهم فهمت أهمية المعلومات، فإذا كانت الأمثلة التي أعطيها قليلة أو ناقصة أو غير متنوعة، فقد تكون النتيجة خاطئة.
ببساطة، الذكاء الاصطناعي يتعلم من الأمثلة التي نعطيه إياها، ولذلك كلما كانت الأمثلة أفضل ومتنوعة أكثر، زادت فرصة أن تكون نتائجه أفضل.
عندما يتعلم الروبوت المشي
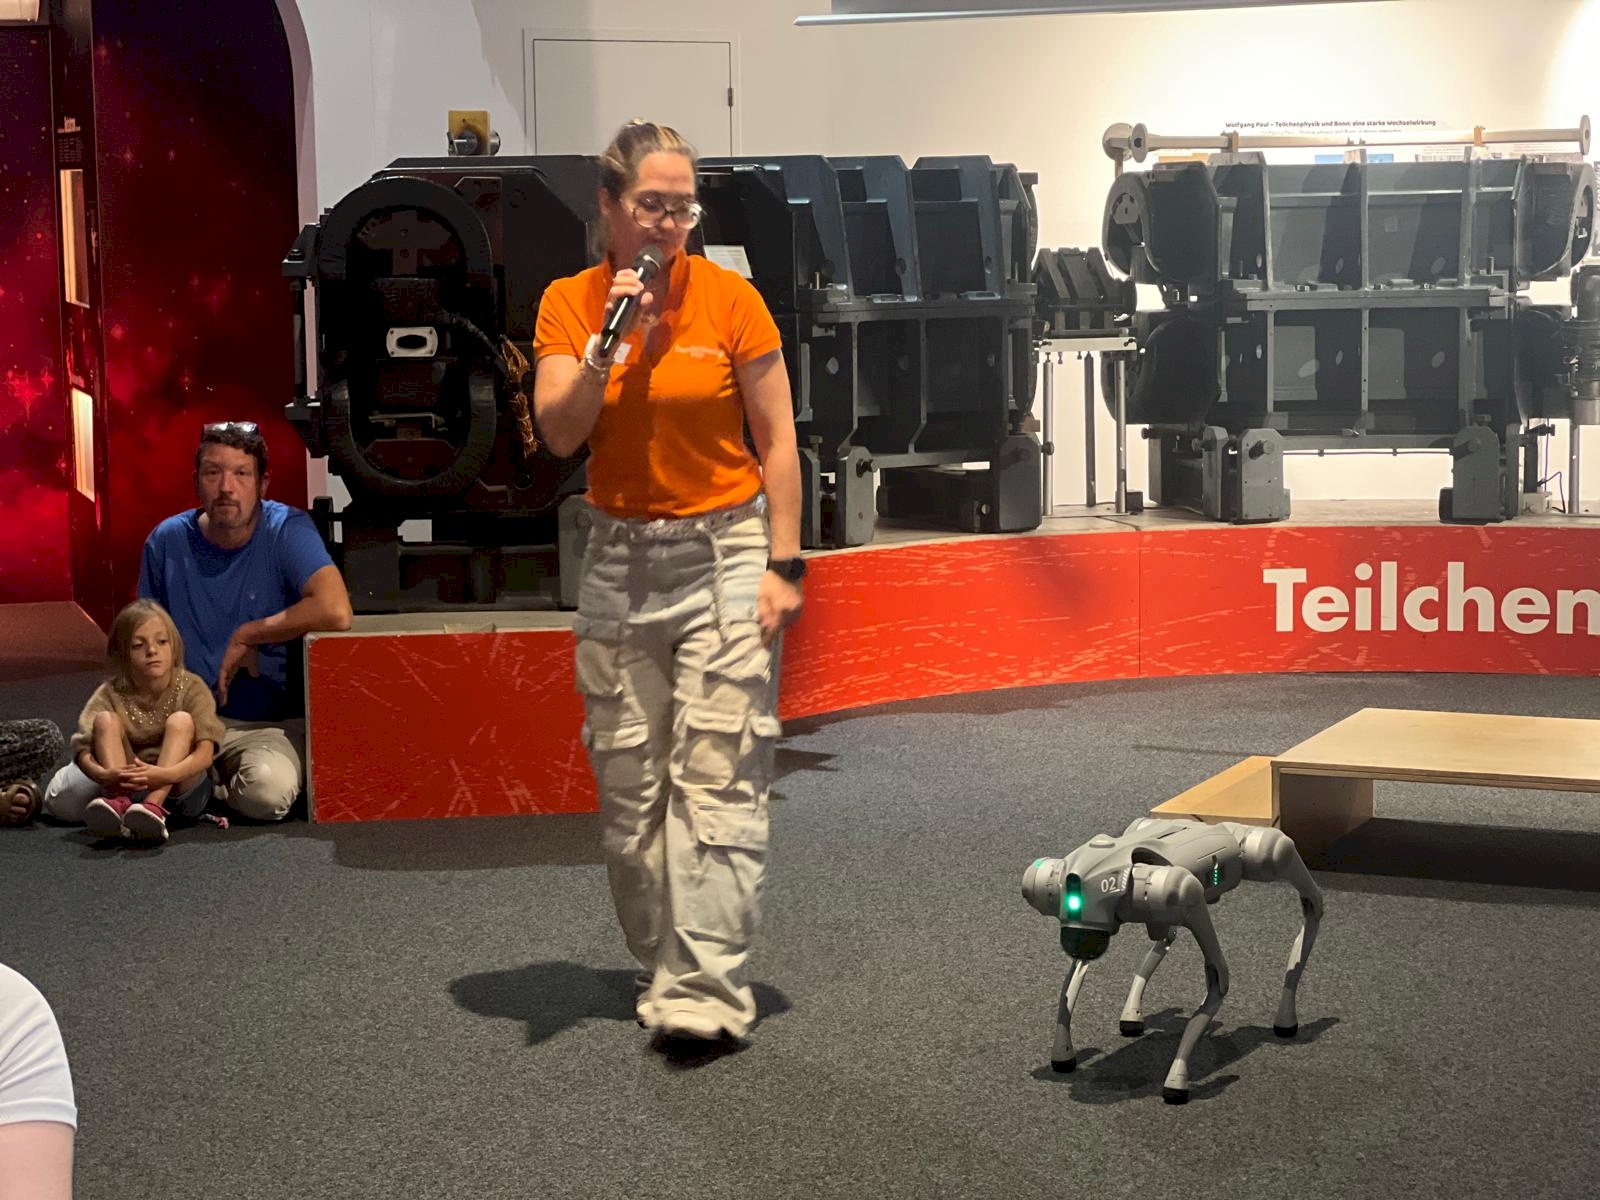
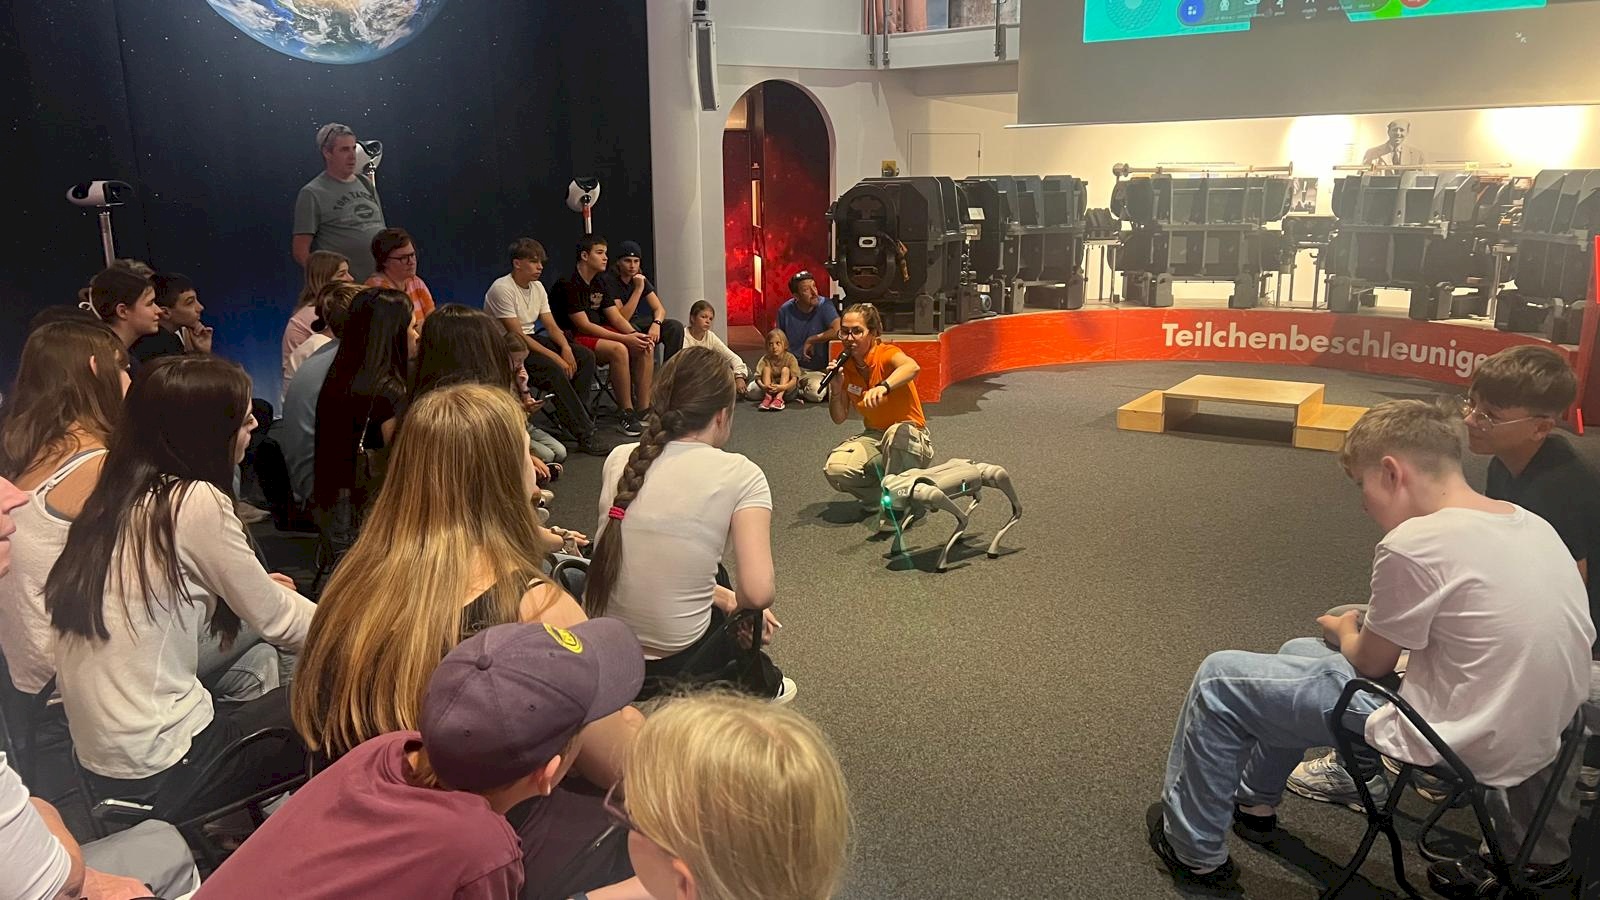
في إحدى محطات الجولة، ألتقي بكلب لا ينبح ولا يحتاج إلى مدرّب يقوده؛ إنه كلب آلي، صُمم ليحاكي حركة الكلاب وقدرتها على التوازن والتنقل في بيئات مختلفة.
يبدأ في التحرك، ويصحح خطواته ويتعامل مع محيطه بطريقة تثير الفضول. ويمكن لمثل هذه الروبوتات أن تُستخدم في البحث والإنقاذ، والتفتيش في الأماكن الخطرة، والمراقبة، ونقل المعدات في البيئات التي يصعب على الإنسان الوصول إليها.
لكن الفكرة هنا ليست استعراض روبوت لطيف؛ إنها محاولة لفهم كيف يمكن للروبوت أن يتعلم الحركة والتعامل مع البيئة من خلال البيانات والخوارزميات والتجربة.
فالزائر لا يرى النتيجة النهائية فقط، بل يقترب من السؤال:
كيف يمكن لروبوت أن يتعلم شيئًا يبدو لنا طبيعيًا وبديهيًا مثل المشي؟
ماذا لو أصبحت السيارة هي من يقرر؟
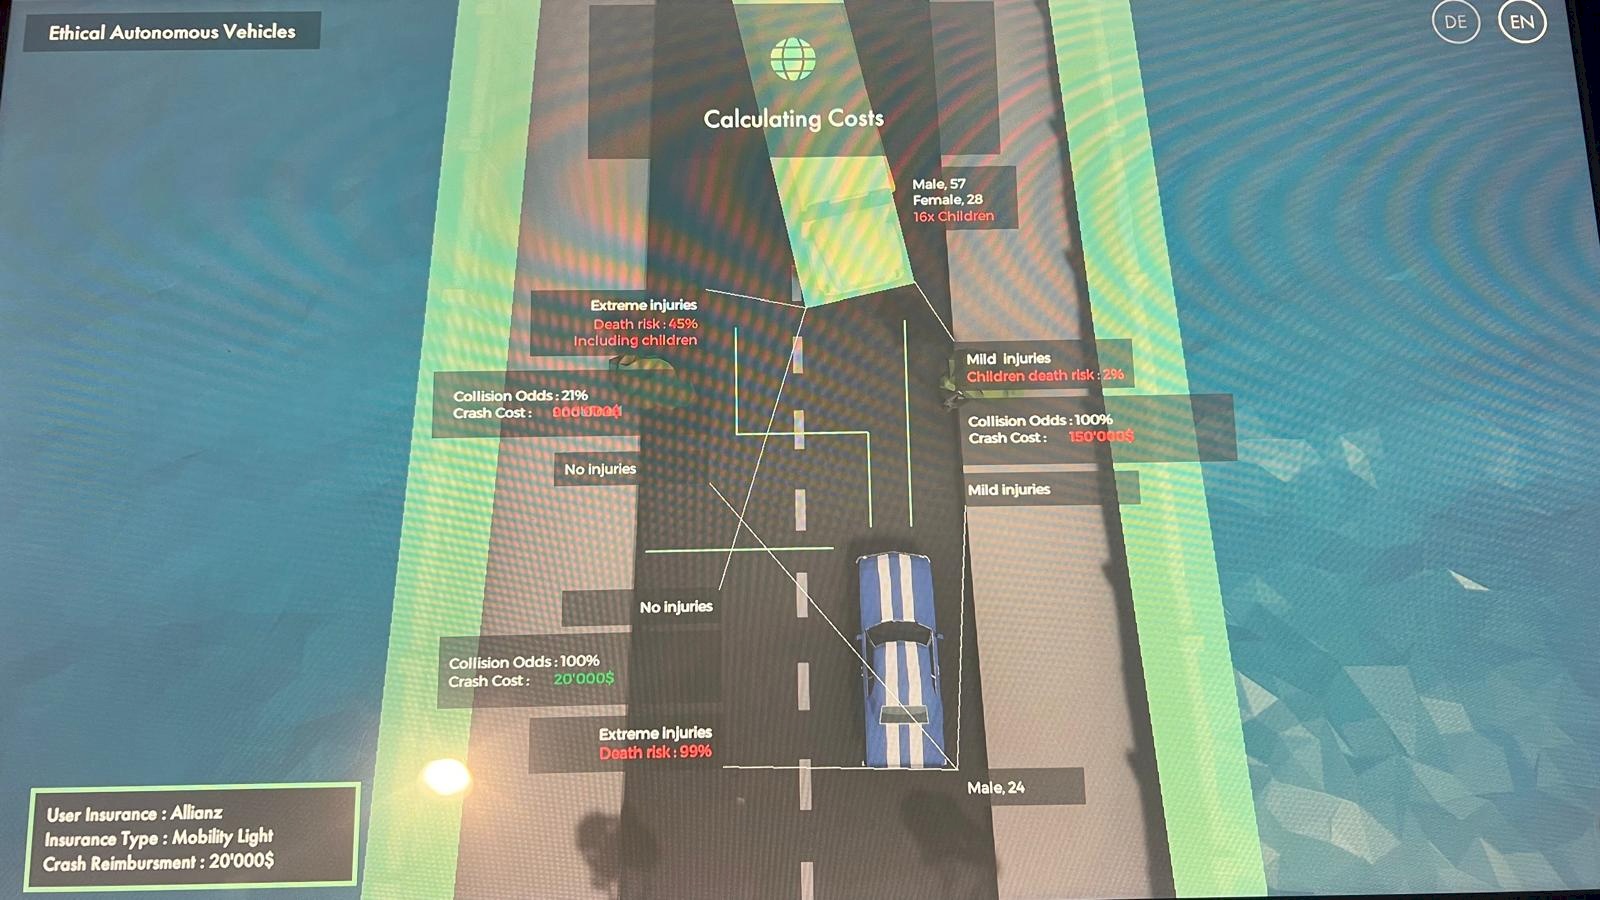
أواصل الجولة، فأجد نفسي أمام تجربة لسيارة ذاتية القيادة.
موقف حادث، أشخاص على الطريق، أطفال، سيارات أخرى ومركبات طوارئ. أمام السيارة أكثر من خيار، ولكل خيار احتمالات مختلفة للإصابة وتكاليف مختلفة.
يبدأ النظام في تحليل الموقف، وحساب احتمالات الخطر والخسائر، ثم يحاول اختيار القرار الذي يراه الأفضل.
لكن التجربة لا تريد مني أن أتعلم كيف تقود السيارة ذاتية القيادة، بل أن أفهم كيف يمكن للذكاء الاصطناعي أن يتعامل مع موقف معقد، ويحوّله إلى أرقام واحتمالات، ثم يستخدمها للوصول إلى قرار.
وهنا يصبح السؤال أصعب:
عندما لا يكون هناك خيار مثالي، هل يوجد فعلًا قرار "أفضل" وقرار "أسوأ" عندما تكون الخيارات مرتبطة بخسارة أرواح أو أضرار مادية؟ ومن الذي يحدد ذلك أصلًا؟
وهنا تكمن قيمة التجربة؛ فهي تجعلنا نفكر في أن القرارات التي تبدو للإنسان أخلاقية ومعقدة، قد تتحول داخل أنظمة الذكاء الاصطناعي إلى حسابات وقواعد واحتمالات.
والسؤال الأخير يبقى مفتوحًا:
هل نريد فعلًا أن نترك لنظام ذكاء اصطناعي قرارًا قد يتعلق بحياة البشر؟
عندما يحاول الذكاء الاصطناعي إعادة لون التاريخ
وفي محطة أخرى، يأخذ المعرض منعطفًا مختلفًا تمامًا.
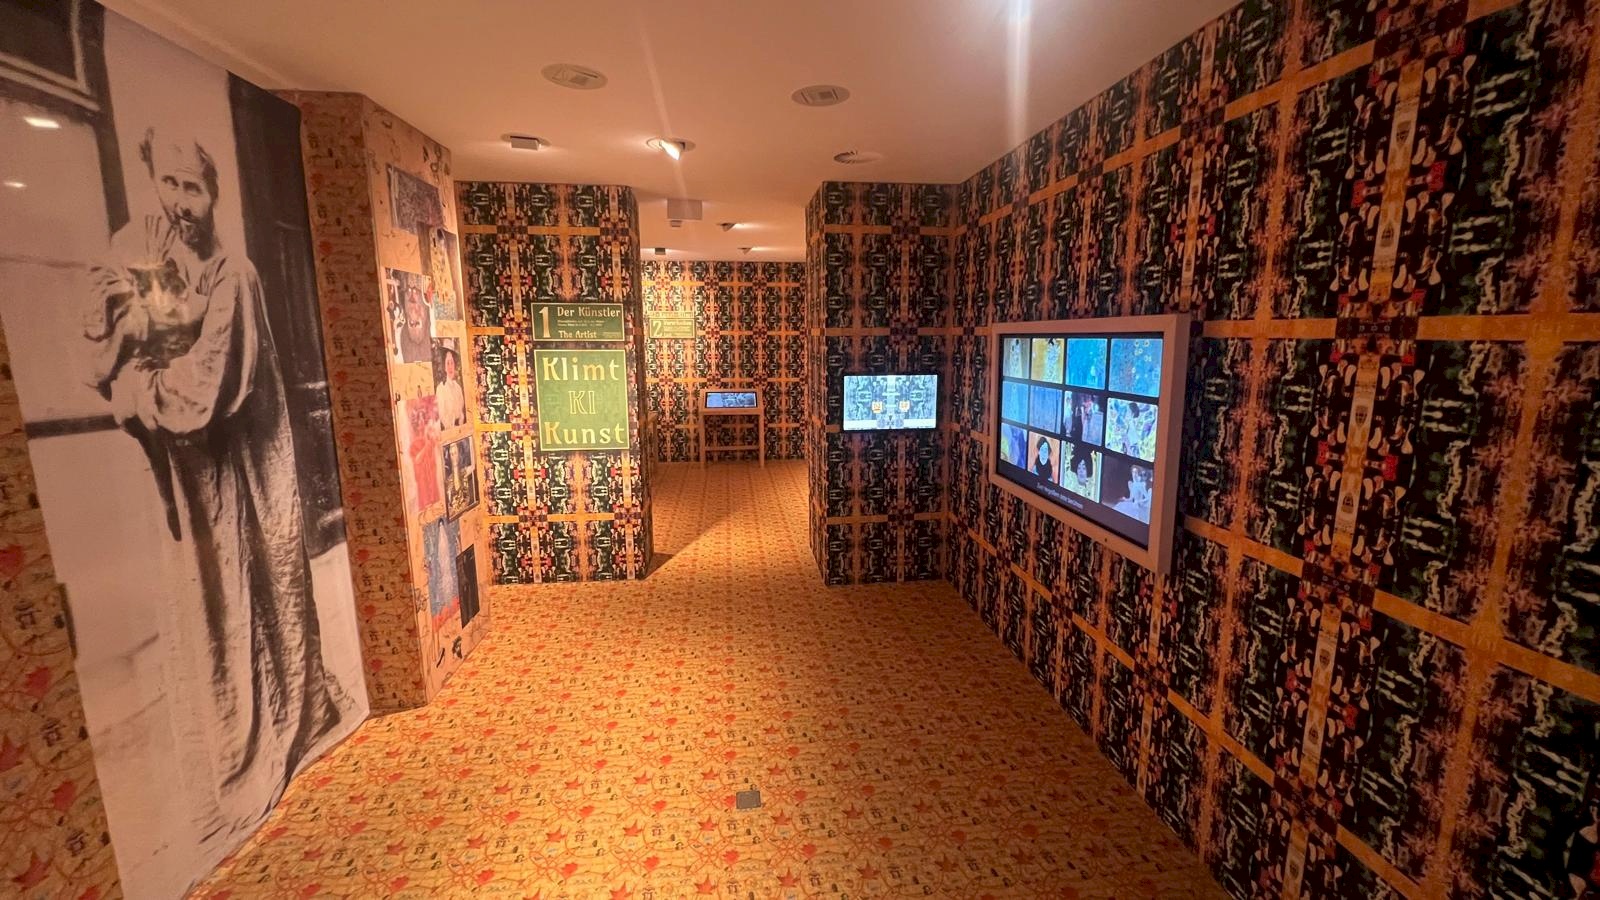
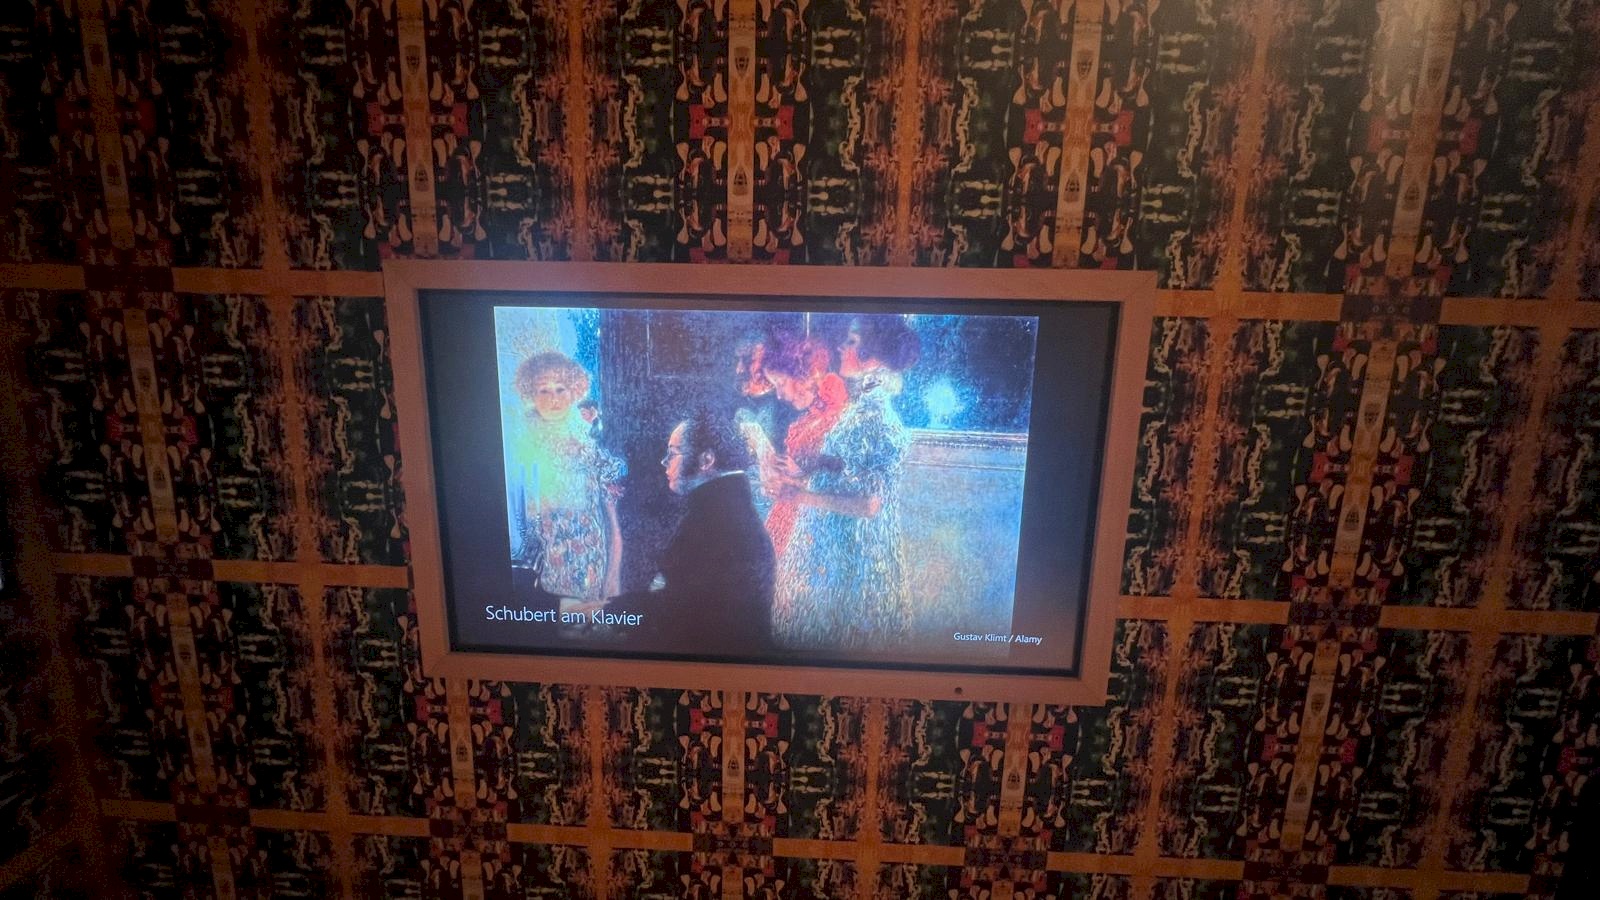
أمامي لوحات وأعمال فنية بألوان نابضة، لكن خلف هذه الألوان قصة عن فن فُقد جزء منه إلى الأبد.
إنها أعمال الفنان غوستاف كليمت التي فُقدت خلال الحرب العالمية الثانية. لم يبقَ منها سوى صور فوتوغرافية بالأبيض والأسود، وبعض المعلومات والأوصاف التاريخية، بينما بقيت ألوانها الأصلية لغزًا.
هنا يدخل الذكاء الاصطناعي في محاولة لاستعادة ما لم يعد موجودًا.
بالتعاون مع خبراء في مجال الفن، تُحلَّل الصور والمعلومات المتبقية، وتُحوَّل الألوان والدرجات المختلفة إلى قيم رقمية يمكن للحاسوب مقارنتها وتحليلها، ثم تُستخدم هذه المعلومات إلى جانب المعرفة بتاريخ الفن لمحاولة تقدير الألوان التي ربما كانت موجودة في اللوحات الأصلية.
لكن الأهم أن الذكاء الاصطناعي لا يخبرنا بالحقيقة المفقودة، بل يقدم احتمالات تساعد الخبراء على إعادة تصورها.
وهنا تكمن قيمة التجربة؛ فهي لا تعرض لنا لوحة جميلة أعيد تلوينها فحسب، بل تجعلنا نفكر في قدرة الذكاء الاصطناعي على مساعدتنا في استعادة جزء من تاريخ لم يعد بإمكاننا رؤيته، مع بقاء الإنسان صاحب الدور الأساسي في التفسير والتقييم.
والسؤال الذي تتركه التجربة مفتوحًا:
هل يمكن للتكنولوجيا أن تساعدنا في استعادة ما فقدناه، دون أن تتحول الاحتمالات التي تقدمها إلى حقيقة نصدقها؟
للذكاء الاصطناعي تكلفة نجهلها!
حتى هذه اللحظة، كان الذكاء الاصطناعي بالنسبة لي شيئًا يحدث على الشاشة. أكتب سؤالًا، أضغط زرًا، وتظهر النتيجة خلال ثوانٍ.
ثم أصل إلى تجربة مختلفة تمامًا.
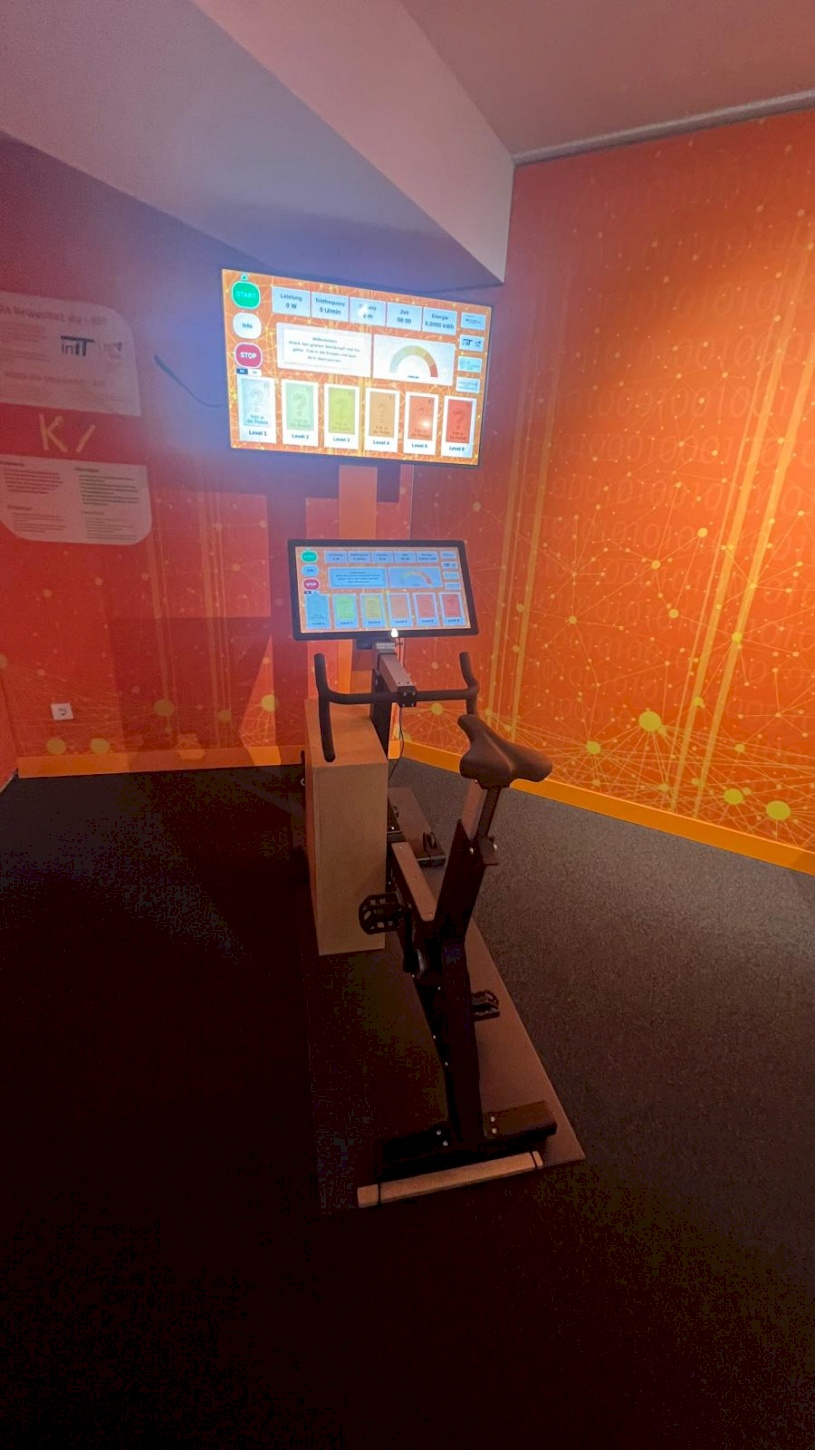
دراجة ثابتة.
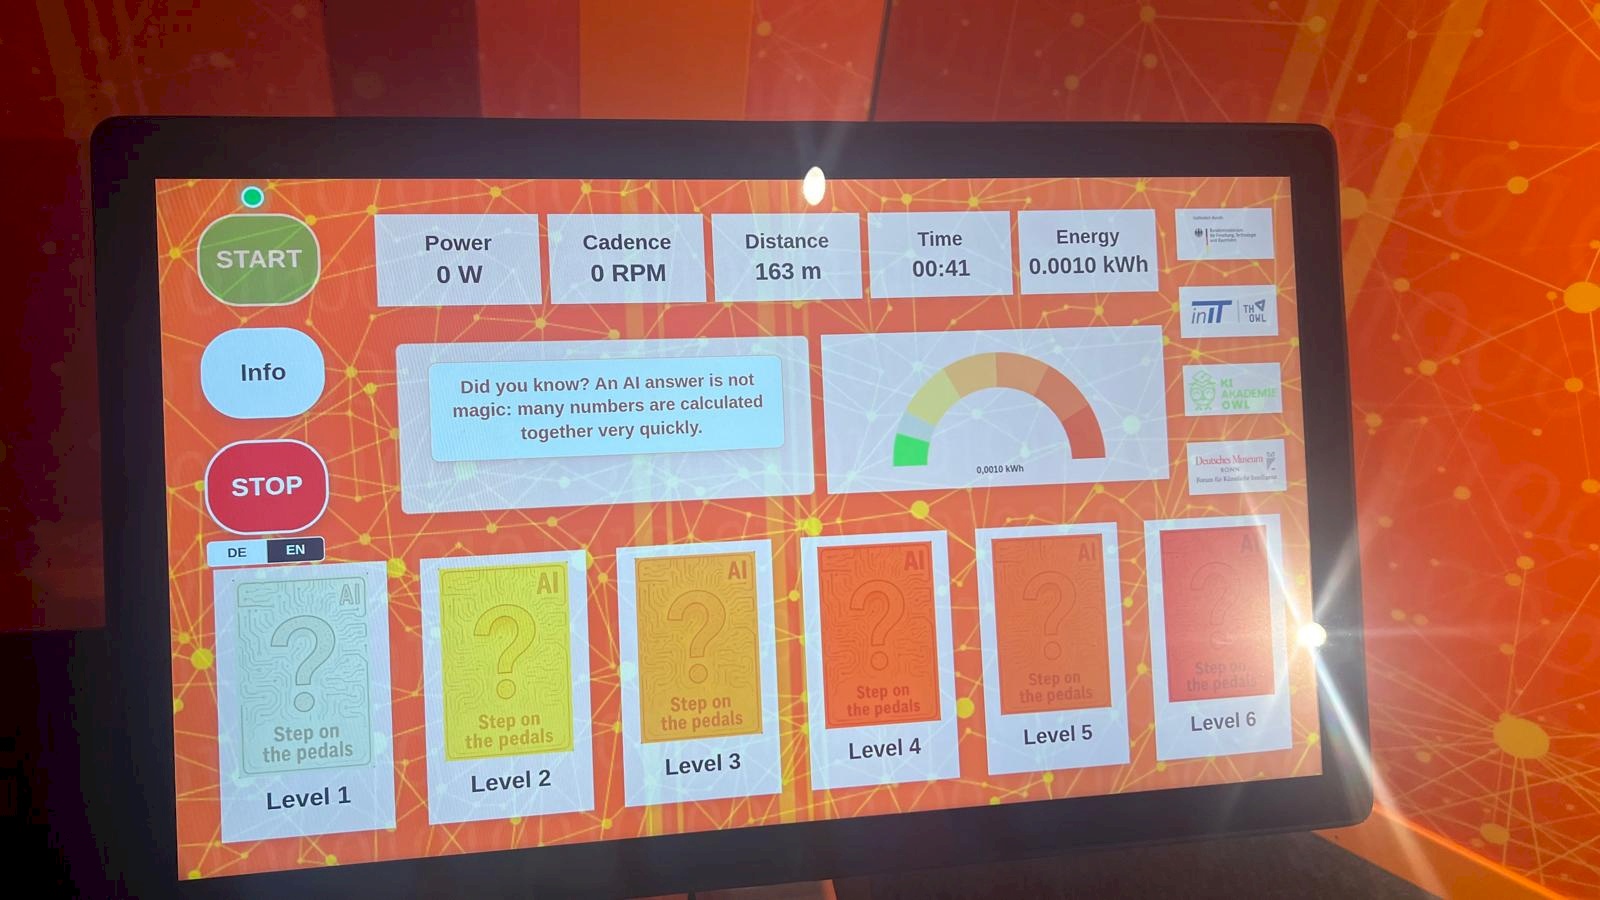
أبدأ بالدوس على الدواسات، وتظهر أمامي أرقام توضح الطاقة والوقت والمسافة والاستهلاك.
فجأة، يصبح شيء لا نراه عادةً شيئًا يمكنني أن أشعر به.
فنحن نكتب سؤالًا فتصل الإجابة، ونطلب صورة فتظهر أمامنا، لكن وراء هذه السرعة أجهزة ومراكز بيانات تحتاج إلى الكهرباء والتبريد والمياه والمواد الخام حتى تعمل.
وإذا أردت أن تعرف حجم الطاقة التي يمكن أن تستهلكها هذه العمليات، عليك أن تركب الدراجة وتواصل الدوس بسرعة وجهد كبيرين، فالمتحف يربط الجهد الذي تبذله بما تحتاجه أنظمة الذكاء الاصطناعي لإنتاج صورة، أو كتابة نص، أو إنشاء أغنية، أو إنتاج فيديو وغيرها من المهام. كلما زادت المهمة تعقيدًا، زادت الموارد الحاسوبية التي تحتاجها. وهكذا يحوّل المتحف استهلاك الطاقة الذي يحدث بعيدًا عن أعيننا إلى تجربة نستطيع أن نراها ونشعر بها.
وتعرض التجربة أيضًا بعض الحلول، مثل استخدام الطاقة المتجددة، وتحسين أنظمة التبريد، والاستفادة من الحرارة الناتجة، وتطوير برامج أكثر كفاءة.
وهنا يتبادر إلى الذهن سؤال لا يمكن تجاهله:
كلما أصبح الذكاء الاصطناعي أقوى وأكثر استخدامًا في حياتنا، هل يجب أن نسأل أيضًا: كم تكلّفنا هذه القدرة؟
ثم تصبح خصوصيتي جزءًا من التجربة
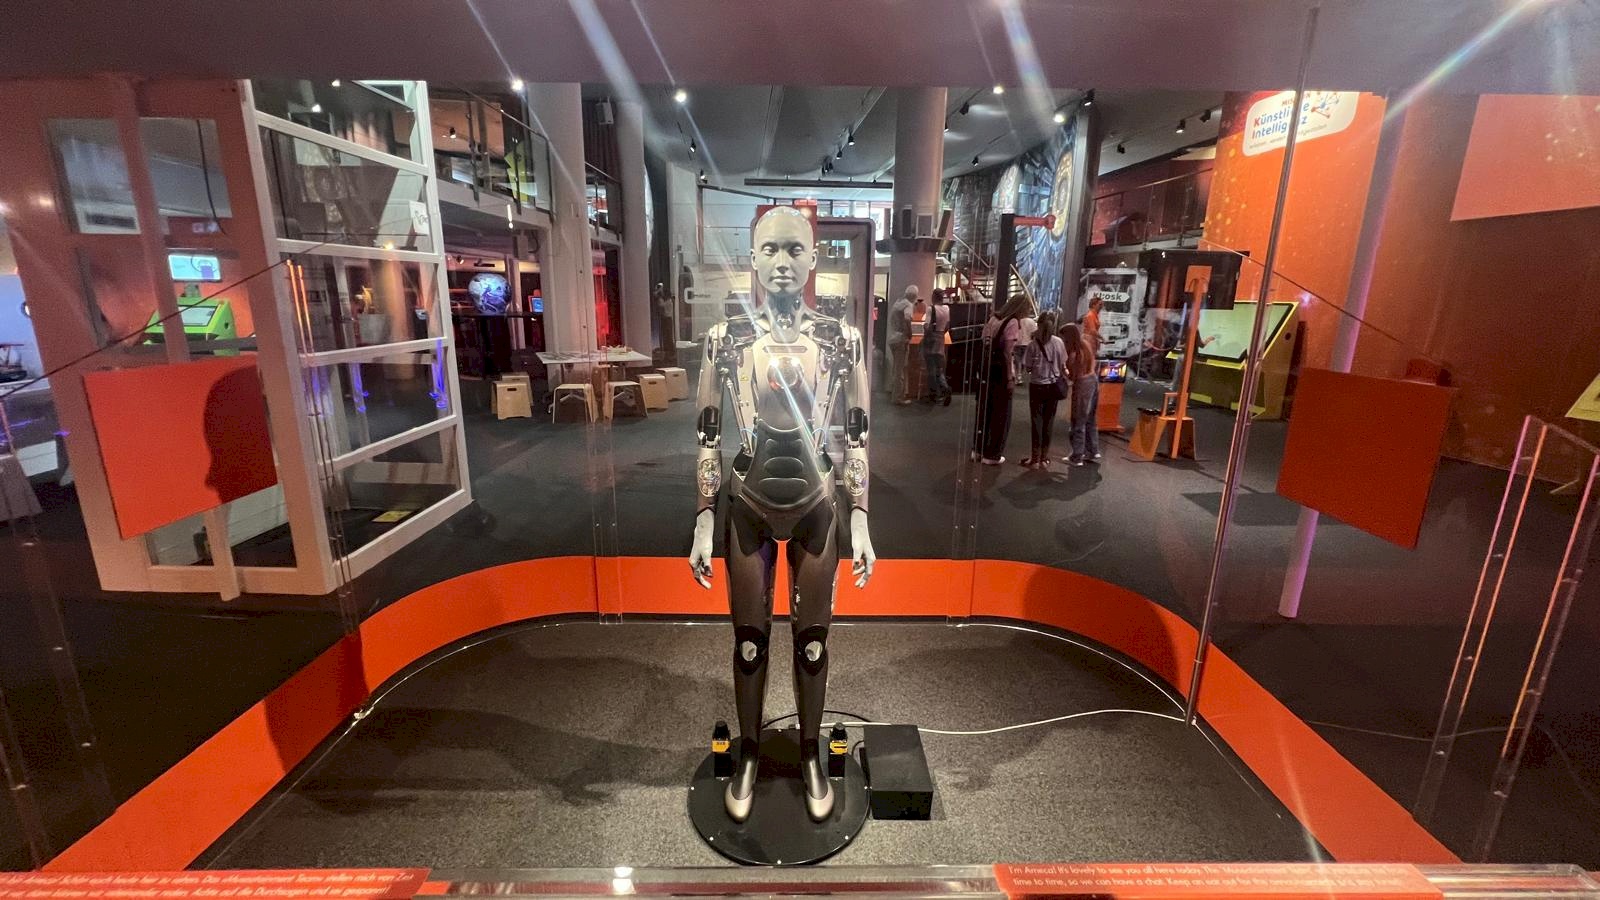
أصل إلى روبوت يشبه الإنسان... أنظر إليه وأتحدث معه، فينظر إليّ ويتفاعل معي، لكن بجانبه أجد تنبيهًا واضحًا: هذا الروبوت قد يجمع الصوت والصورة وبيانات التفاعل.
وهنا أفكر: عندما أتحدث مع الذكاء الاصطناعي أو أرسل له صورة، ماذا يحدث لهذه المعلومات؟ وأين تذهب؟
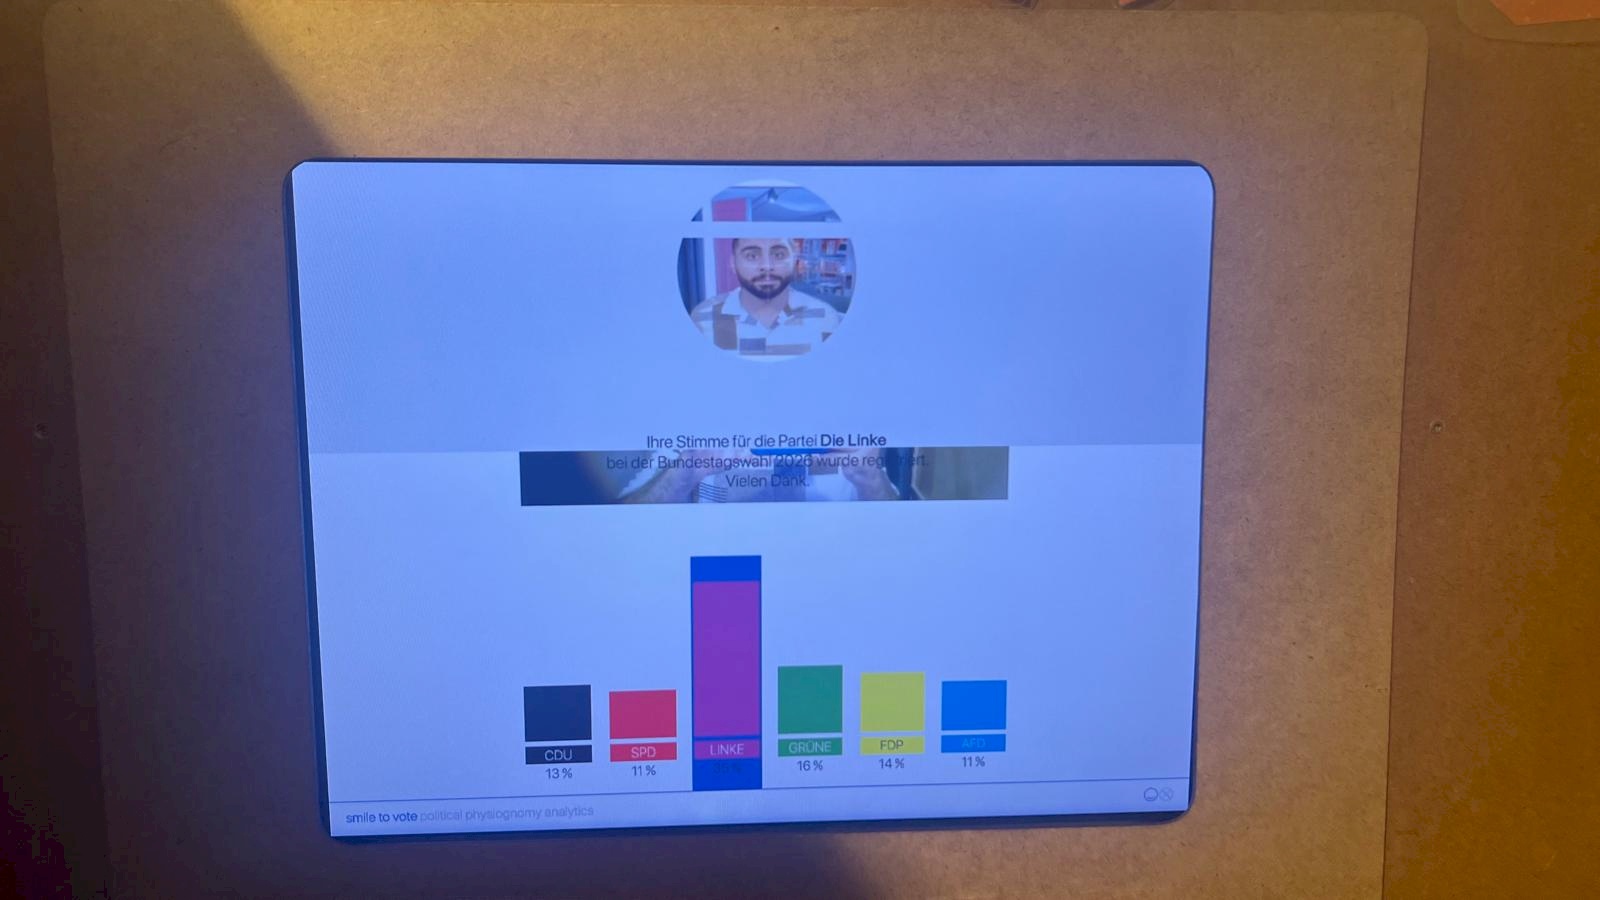
وفي محطة أخرى، أجد تجربة تحاول معرفة التوجه السياسي للشخص من ملامح وجهه.
قد تبدو الفكرة في البداية مجرد لعبة، لكنها تطرح سؤالًا مهمًا:
ماذا لو بدأ الذكاء الاصطناعي يستنتج معلومات شخصية عني لم أخبره بها أصلًا؟
وفي هذه الحالة نستنتج أن ليس كل ما يستطيع الذكاء الاصطناعي معرفته عنّا يعني أنه يجب أن يعرفه.
بعد الجولة… بدأت أرى ما وراء الشاشة
خرجت من المتحف وفتحت هاتفي كالمعتاد.
الأدوات نفسها والنتائج نفسها، لكن شيئًا تغير.
لم أعد أرى النتيجة فقط، بل بدأت أسأل: من أين جاءت البيانات؟ كيف تعلّم النظام؟ كيف وصل إلى هذه الإجابة؟ ماذا يحدث عندما يخطئ؟ ماذا يعرف عني؟ وكم تكلّف هذه التكنولوجيا؟
وربما هذه هي القيمة الأهم التي يتركها المتحف الألماني في بون: أن يأخذك إلى ما وراء الشاشة، لتفهم كيف يتعلم الذكاء الاصطناعي، وكيف يتنبأ، وكيف يصل إلى قراراته، وما يحتاجه من بيانات وموارد، وما الأسئلة الأخلاقية التي يثيرها.
تخرج من هناك وأنت لا تسأل فقط ماذا يستطيع الذكاء الاصطناعي أن يفعل، بل كيف يفعل ذلك.
وأملي أن نرى يومًا مساحة مشابهة في فلسطين، تفتح أبوابها لأطفالنا وشبابنا ومختلف فئات مجتمعنا؛ مساحة لا تكتفي بتعليمهم استخدام الأدوات، بل تساعدهم على فهم ما يحدث خلفها، واكتشاف إمكاناتها وحدودها، وتعلم كيفية توظيفها بوعي ومسؤولية في التعليم والإعلام والعمل ومختلف مجالات الحياة.
فالمستقبل لا يحتاج فقط إلى من يجيد استخدام الذكاء الاصطناعي، بل إلى من يفهمه.